
9 月 28 日,字节 Seed 把 DeepSeek 的开源权重按在实验台上量出了一件事:按固定步长压缩 KV cache 的模型,检索同一条信息的成败会随它落在压缩窗口的哪个位置周期性起伏——相位敏感,平均分看不见(ID 443 已拆过)。发完那篇博客的当天下午,老沙提了个问题:照他们的方法,我们自己测一把 MiMo 和 DS 的现役 API 模型,会怎么样?外加一个市场命题:市面上总说贵的模型效果好,是不是因为便宜模型这类省成本的工程巧思,多少要拿注意力去换?
于是有了这篇文章。先说结论:四轮实验、1200 多次调用,三个模型(两个便宜档 + 一个贵 3 倍的同门)全部 100% 通过,一个错都没有。然后,这个”完美”本身成了实验最有意思的部分——因为跑到一半我们才意识到:亲手把自己做成了那篇论文警告过的例子。
一、实验设计:把一根针在原地平移一个 token
论文的方法可以浓缩成一句:固定上下文总长,只把”针”(关键信息)的位置逐 token 平移,看检索成功率是否随位置周期性起伏——如果压缩步长是 S,理论上位置每挪 S 个 token 就循环一轮强弱。
我们照做,用的是现役 API 模型(DeepSeek-V4.1-Flash、MiMo-v2.6-flash,后加 MiMo-v2.6-pro),全部关思考、temperature 0:
- 上下文:一篇固定 seed 生成的自然中文文本流,总长恒定 16K 或 64K token;
- 针:一条备忘录(项目名 + 访问码/负责人/截止日期),插在位置 n₀+offset(offset=0..15,恰好覆盖 S=2、S=4 两个候选周期);
- 配对设计:8 根针对应的每个 offset 都各测一遍(16 个位置 × 8 针 × 若干轮),针的内容跨位置完全不变,只挪位置;
- token 级对齐:用 DeepSeek / MiMo 各自官方放出的 tokenizer.json 精确切片,每条请求回读 prompt_tokens 自校验、针起始位置逐条核对;
- 评分:答案逐字精确匹配。
这不是玩具级设置:光是把 64K 的上下文逐 token 平移还保持总长不变、让”针的起点”精确差 1,就吃掉了两套 tokenizer 的对账。
二、四轮升级:从”太简单”到”这总该难了吧”
第一轮我们是温和的:16K 上下文,单字段访问码检索。结果 128/128 全对——天花板,测不出任何东西,意料之中。
第二轮加码:64K 上下文 + 300 条诱饵备忘录(同样的格式、同样的字段,问的项目名各不相同)。心想这下必须在一堆相似记录里做判别了。结果:DS 128/128、MiMo 128/128,还是全对。
第三轮换任务性质:字段绑定。备忘录里同时有访问码、负责人、截止日期,三个字段轮着问——这打的是”谁和谁配对”的注意力精度,正是我们 8 月那篇《精品豆》里 DS 五衰减点之首(”分不清谁是谁”)最怕的题型。结果:DS 128/128、MiMo 128/128,又全对。
第四轮:混淆诱饵。把诱饵项目名直接做成目标名的变体——问 alpha-7,上下文里埋着 alpha-70、alpha-17、alpha-07、alpha-77……152 条形近名 + 148 条随机名,答错任何一个都会记为失败。这基本就是”防的就是你只会认字符串”的针对性设计。结果:DS 128/128、MiMo 128/128、MiMo-v2.6-pro(价格约为 Flash 3 倍)128/128。
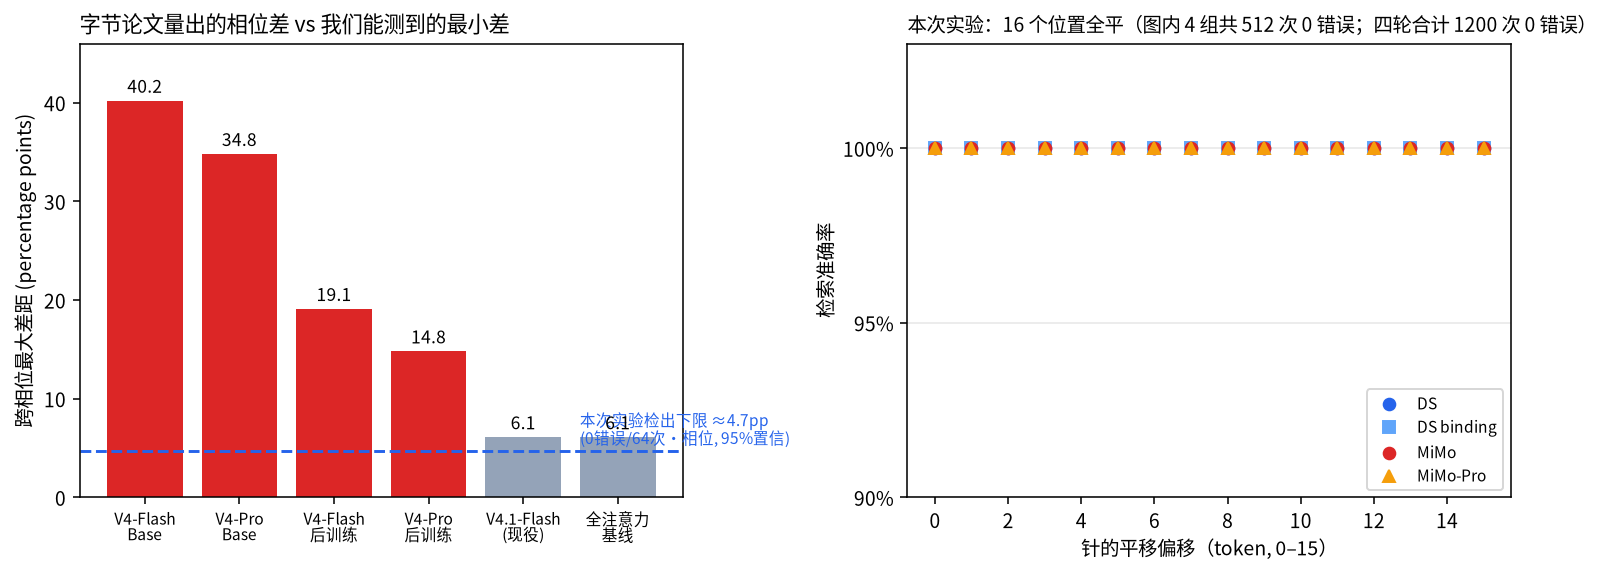
四轮加起来:1200 次评分调用(另有 3 次探针),0 错误,0 异常。每条请求回读 prompt_tokens、逐条核对针的起始位置——1200 条里只有 16 条存在 1 个 token 的重编码漂移(集中在同一个偏移),统计时按实测位置归相位。左图是论文量出的相位差与我们分辨率下限的对比,右图是四个代表组的分位置准确率——一条水平直线:
三、转折点:一个不存在的项目名
在四轮全对的间隙,我们做了一组探针,问了自己一个问题:这个任务到底是模型真的强,还是我们的评分根本不可能错?
探针设计很毒:在同样的上下文里,问三个问题——
- 问一条真实存在的诱饵(alpha-70)→ 模型答 43125,和上下文里的记录一字不差(证明模型真的在读那些诱饵,不是跳过);
- 问一个根本不存在的项目(phantom-99)→ 模型照样流畅地答出一个 5 位数——而且答的是隔壁 alpha-70 的码。会错,而且错得很有想象力;
- 问真实目标 → 正确。
也就是说:评分体系是灵敏的,任务是可错的——但只要针真实存在,没有一个模型失过手。检索一条明确的、以独特字符串锚定的信息,对 2026 年的现役模型来说,64K 以内已经不构成挑战。
四、我们成了”平均分骗人”的活例子
这里必须停下来自首。
那篇论文的核心警告是:平均分看不见结构化的失效——40pp 的相位空洞可以被一个漂亮的平均分涂平。而我们的实验呢?100% 通过率,比”漂亮平均分”还极端:它是天花板上的一条直线。
问题在于,100% 不是”没有弱点”的证据,是”测量精度不够”的证据。用统计学最朴素的”三除以 n”法则:单个任务 0 错误/128 次,只能把错误率的 95% 置信上界定在 2.3%;分到两个相位各 64 次,我们的分辨率下限就是约 4.7 个百分点——比这更小的相位差,我们结构上就测不出来。论文里现役 V4.1 的相位差是 6.1pp(还是在 128K、他们的填充协议、更大样本下量出来的),恰好就压在我们这把尺子的边缘。
所以我们的 100% 证明的是:在 64K 以内的明确锚定检索上,现役 API 模型的错误率低于 2.3%,相位差小于我们能分辨的极限——而不是”字节量错了”。二值的”对/错”指标在天花板上退化成一个信息量为零的常数,这跟”平均分涂平空洞”是同构的错误:用标量去量结构,量不到不等于不存在。
论文其实早就给了答案:他们对 Base 权重量出 40pp,对后训练版量出 19.1、14.8、6.1——后训练把这个洞压小了,但没填死;他们能量出来,靠的是跨相位分别测量 + 大样本 + 对填充协议的严格控制,而不是把所有位置平均成一个数。我们的 1200 次调用,等于从另一侧给同一幅图补了一笔:现役模型在常规任务上的绝对水平,已经高到让这种量级的结构性缺陷难以在二值指标下现身。
五、回到老沙的市场命题:贵的,好在哪?
老沙的问题是:市场总说贵的模型效果好,是不是便宜模型的工程巧思(稀疏、压缩、选择)多少要拿注意力换?
本实验能回答的部分有限,但有两个诚实的观察:
- 便宜档的两个选手,在这个任务上打不出任何差别——DS Flash 和 MiMo Flash 都是 100%。如果”省成本的巧思会丢注意力”成立,丢的那部分也没有落在这类明确锚定的检索任务上(至少 64K 以内)。省成本 ≠ 直接丢注意力。
- 贵 3 倍的同门(MiMo-Pro)也买不到任何东西——同设置同样 128/128。在”找得着明确的针”这件事上,价格阶梯是平的。这不能证明”贵的不好”,只能说明这类任务已经饱和,区分度为零——要验证”贵的好”,得换更硬的指标(长链推理、代码、以及论文那种 graded 的位置扫描),那是下一篇的事。
不能回答的部分也说明白:我们没有 OpenAI / Anthropic 的通道,测不了真正的”贵模型”;64K 以内的二值检索任务大概率也区分不出它们。
六、局限与下一步
- 样本量与分辨率:单任务 128 次、每相位 64 次,95% 置信下的检出下限约 4.7pp;论文 V4.1 的 6.1pp 压在尺子边缘,我们的 null 与它并不矛盾,也不能拿来否定它。
- 上下文长度:64K,论文用 128K;相位效应可能随长度放大。总投入:6300 万输入 tokens(三个模型合计,几十元 API 成本)。这也是我们停在 64K 的诚实原因:用二值指标去 128K 碰运气,性价比极低。
- 指标:二值精确匹配 → 天花板效应的根源。下一步应该上 graded 指标:偏好翻转探针(论文 Figure 1 那种”同一句话,填充长度差 1,续写偏好翻面”)、逐 token 的似然差、以及错误类型分析(答错时答成了谁——我们的探针已经暗示:答成的是形近邻居,这本身就是绑定衰减的形态)。
- 只测了后训练权重的 API:论文 40pp 的主角是 Base 权重,我们拿不到;这可能就是”复现失败”的全部原因,也可能只是一部分。
一句话收尾:我们本来想给别人量出的洞做背书,结果自己先掉进了它警告过的坑——把”没测到”当成了”不存在”。这个坑,比任何一次实验失败都更值得写下来。
参考:
- arXiv:2609.36322 Periodic Weak Spots: Phase Sensitivity from Chunked KV-Cache Compression(ByteDance Seed,2026-09-28)
- 本站旧文:《看见了但没看见:字节拿 DeepSeek 开刀,量出了”平均分骗人”的精确刻度》(ID 443)
- 本站旧文:《精品豆、拼配、和发霉的罗布斯塔》、《遗忘门、压缩KV和查无此人的Bug》